60 jours avant le BFCM : les workflows n8n à construire en octobre, pas en novembre
La surveillance de pic n'est pas un tableau de bord, c'est un ensemble de workflows qui remarquent les choses pendant que vous dormez. Cinq automatisations à construire avant le gel, avec la logique et les seuils.
7 min de lecture
Le Black Friday tombe le 27 novembre, ce qui place aujourd'hui à une soixantaine de jours et à environ quarante jours ouvrés d'un gel raisonnable. En août, nous avons publié la checklist technique BFCM et décrit l'écran de supervision qui doit exister pendant le pic. Voici la suite : comment le construire.
S'il relève d'octobre, c'est parce qu'une automatisation construite pendant un incident est une automatisation à laquelle personne ne fait confiance. Un workflow qui tourne discrètement depuis la mi-octobre sans produire de fausse alerte est un workflow que votre équipe croira à deux heures du matin le 28 novembre. Un workflow déployé le 26 ne l'est pas.
Pourquoi des workflows plutôt que des tableaux de bord
Un tableau de bord suppose que quelqu'un le regarde. Pendant le pic, la personne censée le regarder fait autre chose, et les défaillances les plus coûteuses sont celles qui ne produisent aucun symptôme visible. L'extinction des Scripts en juin et l'échéance des pages de remerciement en août avaient toutes deux cette forme : impact sur le chiffre d'affaires, totalement silencieux, découvert des semaines plus tard.
La distinction qui compte est entre rapporter et remarquer. Un rapport vous dit ce qui s'est passé quand vous le demandez. Un workflow vous dit que quelque chose ne va pas au moment où cela ne va pas.
⚙️
Tout ce qui suit tourne confortablement sur une instance n8n auto-hébergée. Si vous en montez une, notre guide d'auto-hébergement de n8n sur AWS couvre le déploiement, et notre comparatif avec Zapier et Make couvre le choix si vous ne l'avez pas encore fait.
Les cinq workflows
1. Écart du rythme de commandes
L'alerte la plus utile que vous puissiez faire tourner, parce que presque toute défaillance sérieuse en amont s'y manifeste en premier. Checkout cassé, passerelle de paiement dégradée, compte publicitaire suspendu, problème DNS : tous font baisser les commandes par minute avant de produire le moindre autre signal.
La logique est une comparaison glissante plutôt qu'un seuil fixe, car un seuil fixe est soit inutile un mardi calme, soit hurlant le jour du Black Friday.
// Tourne toutes les 5 minutes. Compare les 15 dernières minutes à la même fenêtre
// sur les 3 jours précédents, ajustée d'un facteur de hausse attendue.
function evaluateOrderRate(current, baselineWindows, upliftFactor = 1) {
  const baseline =
    baselineWindows.reduce((sum, w) => sum + w, 0) / baselineWindows.length;

  const expected = baseline * upliftFactor;
  if (expected < 3) return { alert: false, reason: "volume trop faible pour juger" };

  const ratio = current / expected;

  return {
    alert: ratio < 0.5,
    severity: ratio < 0.25 ? "critical" : "warning",
    current,
    expected: Math.round(expected * 10) / 10,
    ratio: Math.round(ratio * 100) / 100
  };
}
Fixez upliftFactor manuellement avant la semaine de pic à partir de la courbe de trafic de l'an dernier. Envoyez l'alerte dans un canal où un humain se trouve réellement, pas par email.
2. Rapprochement des remises
Juin a montré à beaucoup de boutiques pourquoi cela compte. Plusieurs ont reconstruit leur logique de remise en Shopify Functions dans l'urgence, et le pic est précisément le moment où un écart d'arrondi ou un palier mal appliqué devient coûteux le plus vite.
À faire tourner toutes les heures pendant le pic. Comparez la valeur de remise par commande à une référence glissante et alertez sur l'écart dans les deux sens. Trop de remise vous coûte de la marge immédiatement. Pas assez vous coûte la promotion que vous avez payée pour faire connaître.
3. Profondeur des files d'intégration
Les échecs de synchronisation de commandes sont invisibles côté storefront. Le client finalise, voit une confirmation, et la commande n'atteint jamais votre ERP ou votre 3PL. Vous l'apprenez quand la logistique demande pourquoi la file est vide, question très coûteuse à traiter tardivement en période de pic.
- Alertez sur une croissance soutenue de la profondeur plutôt que sur un chiffre absolu, la profondeur absolue n'ayant aucun sens sans le débit d'écoulement.
- Alertez séparément sur le taux d'erreur, car une file qui s'écoule en générant des erreurs paraît saine si l'on ne regarde que la profondeur.
- Incluez l'âge du plus ancien élément dans l'alerte. Une file de deux cents éléments vieux de trente secondes va bien. Une file de cinq éléments vieux de deux heures, non.
Les schémas d'architecture correspondants sont traités dans notre article sur l'intégration Shopify et NetSuite, et la version dédiée au stock dans notre workflow de synchronisation d'inventaire.
4. Garde-fou stock et survente
Deux modes de défaillance, tous deux aggravés au pic. Survendre un produit que vous ne pouvez pas livrer génère annulations et remboursements en décembre. Le stock fantôme, présent dans le système mais pas physiquement, produit le même effet plus lentement.
Construisez un workflow qui signale tout produit dont le rythme d'écoulement sur la dernière heure implique une rupture avant le prochain cycle de synchronisation. Cela donne au merchandising la possibilité de le retirer des campagnes payantes avant l'épuisement, ce qui est la véritable finalité de l'alerte.
5. Taux de complétion du checkout par étape
Plus diagnostique qu'alertant. Une baisse de commandes vous dit que quelque chose ne va pas. Le taux de complétion par étape vous dit où. Si les étapes information et livraison tiennent et que le paiement s'effondre, vous avez un problème de passerelle et non de site, ce qui change qui vous réveillez.
🔕
Réglez pour le silence. Un workflow qui alerte deux fois par semaine en octobre sera coupé en novembre, et une alerte coupée est pire que pas d'alerte car elle crée une fausse confiance. Si l'un d'eux se déclenche plus d'une fois par semaine en période normale, le seuil est mauvais.
Ordre de construction et calendrier
- Semaine du 29 septembre. Écart du rythme de commandes, en mode observation, alertes envoyées vers un canal sur lequel personne n'agit. Vous calibrez des seuils, vous ne répondez pas encore.
- Semaine du 6 octobre. Profondeur de file et taux d'erreur des intégrations. C'est celui qui a le plus de chances de révéler un problème existant que vous ignoriez.
- Semaine du 13 octobre. Rapprochement des remises et garde-fou stock.
- Semaine du 20 octobre. Complétion du checkout par étape, plus une revue de tous les seuils fixés jusque-là face à trois semaines de données réelles.
- Semaine du 27 octobre. Activez les vraies alertes. Puis laissez tourner sans y toucher pendant quatre semaines, le temps que l'équipe apprenne à quoi ressemble la normale.
- Novembre. Ne changez rien. Si un workflow n'a pas fait ses preuves au 10 novembre, désactivez-le plutôt que de l'envoyer non testé dans le pic.
Le lien avec le runbook
Des alertes sans runbook produisent de la panique, pas une réponse. Chacun de ces cinq workflows doit avoir une entrée répondant à trois questions : ce que l'alerte signifie, quoi vérifier en premier, et qui a le droit d'agir.
Rédigez le runbook par symptôme, pas par système. À deux heures du matin, la personne d'astreinte lit « les commandes se sont arrêtées » et doit savoir quoi faire, pas quel service porte la panne. C'est une leçon que la plupart des équipes apprennent une fois, de la manière coûteuse.
🤖
Nous construisons la supervision et l'automatisation de pic sur n8n auto-hébergé : garde-fous d'intégration, tâches de rapprochement et routage d'alertes, calibrés pour être en place bien avant le gel. Voir notre service d'automatisation des workflows ou contactez-nous.
Questions fréquentes
Pourquoi n8n plutôt qu'un produit de supervision ?
Les produits de supervision surveillent l'infrastructure. Ces alertes relèvent de la logique métier : rythme de commandes, montants de remise, profondeur de file sur vos propres systèmes. Un outil de workflow disposant déjà des accès à votre plateforme e-commerce, votre ERP et votre canal d'alerte est le chemin le plus court.
Auto-hébergement ou cloud ?
L'auto-hébergement donne la maîtrise de la localisation des données et un coût prévisible à volume élevé, ce qui compte si ces workflows touchent des données de commande et de client. Le cloud démarre plus vite. Si vous tranchez en octobre, partez sur ce qui met les workflows en service cette semaine.
J'ai déjà des alertes. Est-ce suffisant ?
Vérifiez ce qu'elles couvrent réellement. La plupart des boutiques ont des alertes d'infrastructure et aucune alerte de logique métier, ce qui revient à surveiller la disponibilité et pas le chiffre d'affaires.
Est-il trop tard pour s'y mettre ?
Non. Soixante jours suffisent confortablement pour les cinq, et les deux premiers apportent déjà l'essentiel de la valeur. Il serait trop tard la première semaine de novembre.
Combien d'alertes attendre pendant le pic ?
Idéalement aucune. Ces workflows existent pour le cas où quelque chose casse en silence, et un pic où ils restent muets est le résultat réussi, pas la preuve qu'ils étaient inutiles.
Sujets connexes
Articles connexes
Tous les articles
Workflow AutomationApr 28, 2026
Comment nous avons remplacé une stack Shopify de 14 apps par 3 workflows n8n (et ce que ça a coûté)
Un vrai cleanup client. Quatorze apps qui faisaient automatisation, panier abandonné, sync de stock et import d'avis. Trois workflows n8n les ont remplacées en deux semaines. Voici l'architecture, les chiffres, et ce que nous referions différemment.
13 min de lecture
Workflow AutomationFeb 20, 2026
Construire un workflow de synchronisation d'inventaire Shopify et NetSuite sur n8n
Le guide pas-à-pas d'un ingénieur pour une synchronisation d'inventaire prête pour la production entre Shopify et NetSuite sur n8n auto-hébergé. Architecture webhook, GraphQL Admin API, gestion des limites de taux et pattern de déduplication qui garde les stocks justes à l'échelle.
17 min de lecture
Workflow AutomationJan 20, 2026
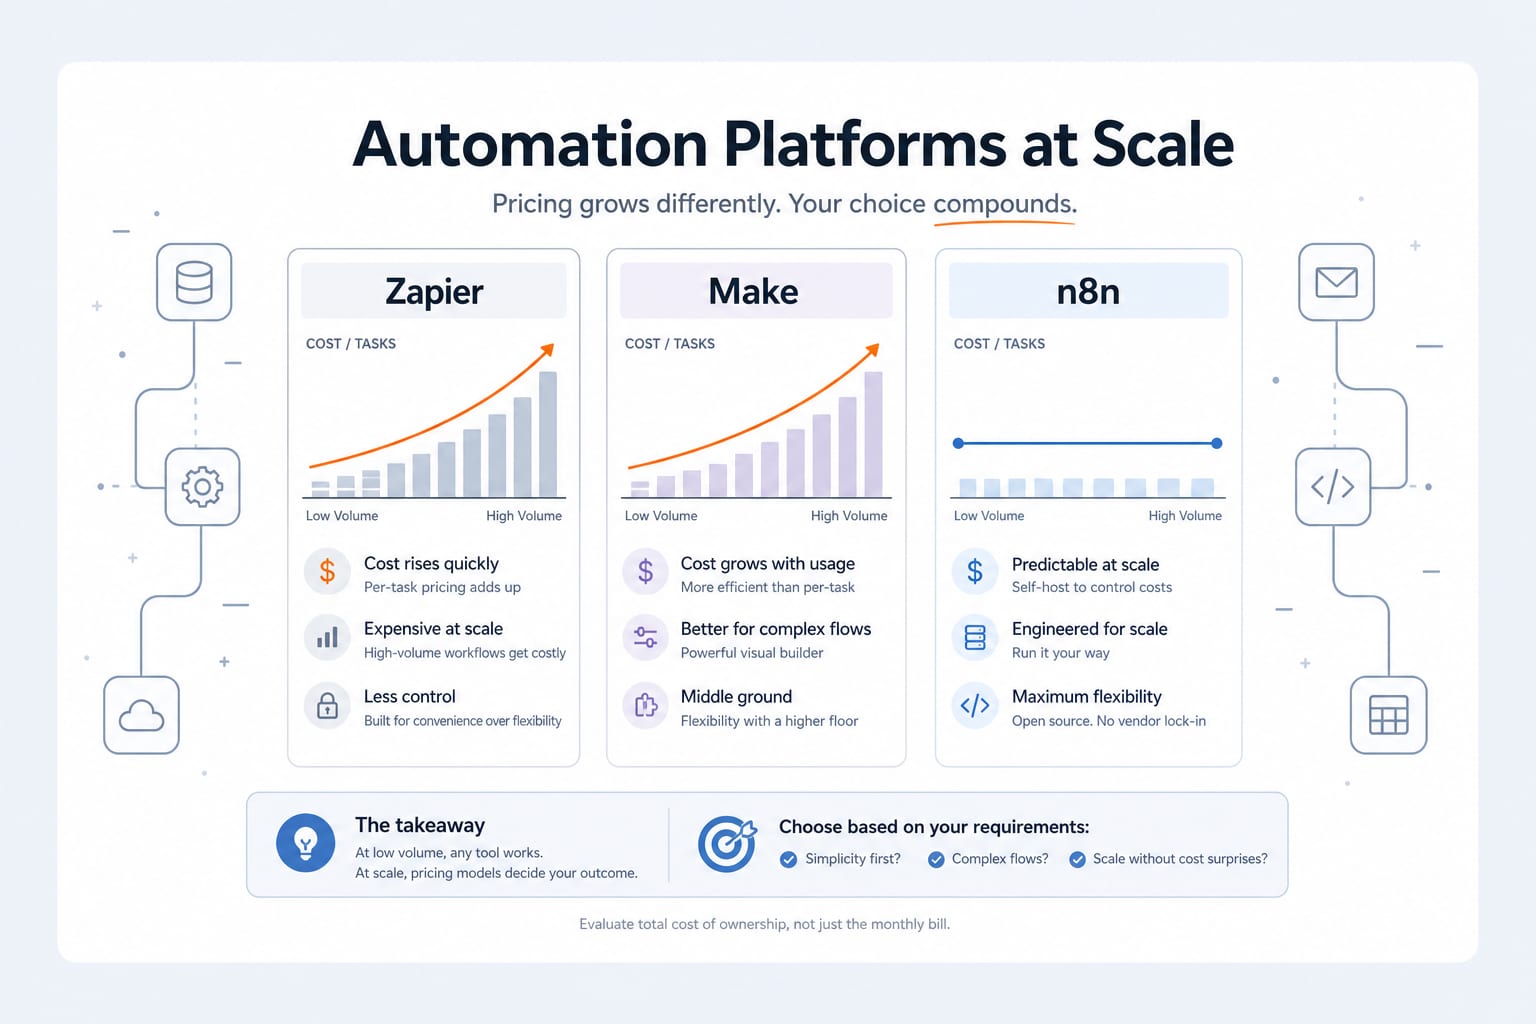
n8n vs Zapier vs Make : comparatif d'ingénieur 2026 (et pourquoi nous auto-hébergeons n8n)
Comparatif honnête 2026 de n8n, Zapier et Make. Tarification à l'échelle, profondeur d'intégration, capacités d'agents IA, souveraineté des données, et la grille de décision que nous utilisons pour cadrer un projet d'automatisation.
12 min de lecture